Lightweight Music Source Separation — Listening Test
同一個模型家族、四種大小(部署後 1.35 – 5.7 MB,INT8 權重),從 44.1 kHz 立體聲混音中分離出人聲與伴奏。 伴奏由「混音減去分離出的人聲」得到,因此一顆模型就能同時輸出兩個音軌。試聽片段取自 MUSDB18-HQ 測試集歌曲 Juliet's Rescue – Heartbeats 的 20 秒(1:35 – 1:55),這首歌從未用於訓練。建議戴耳機聆聽。
客觀評估
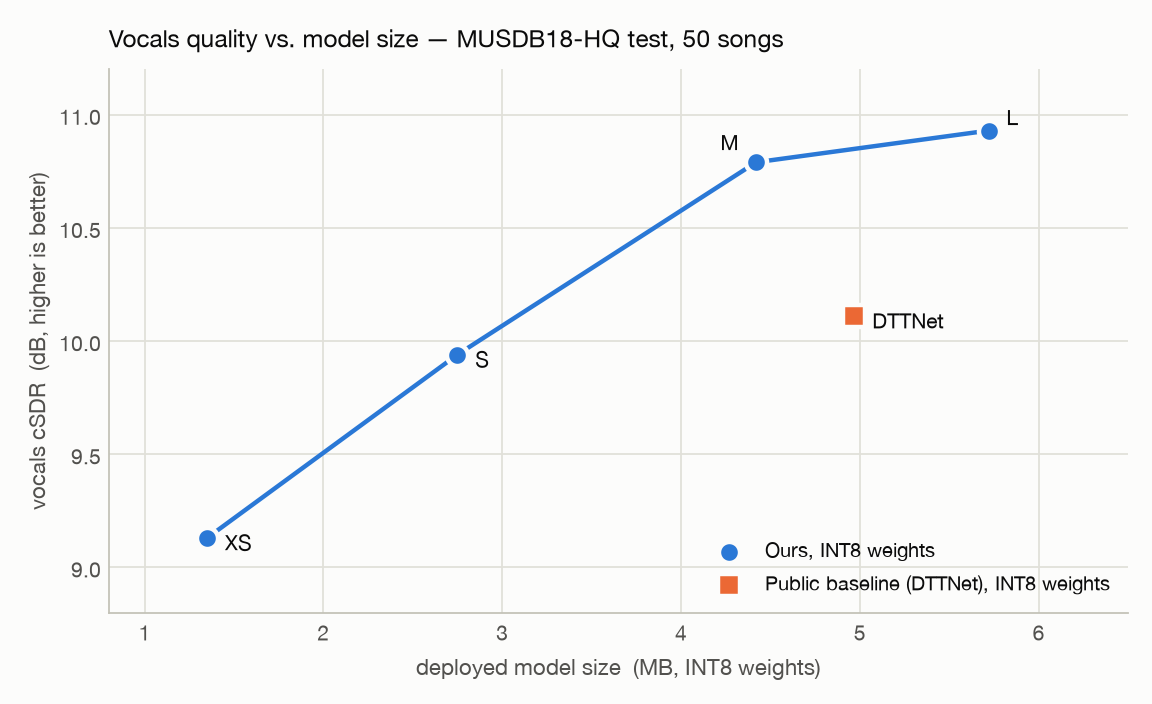
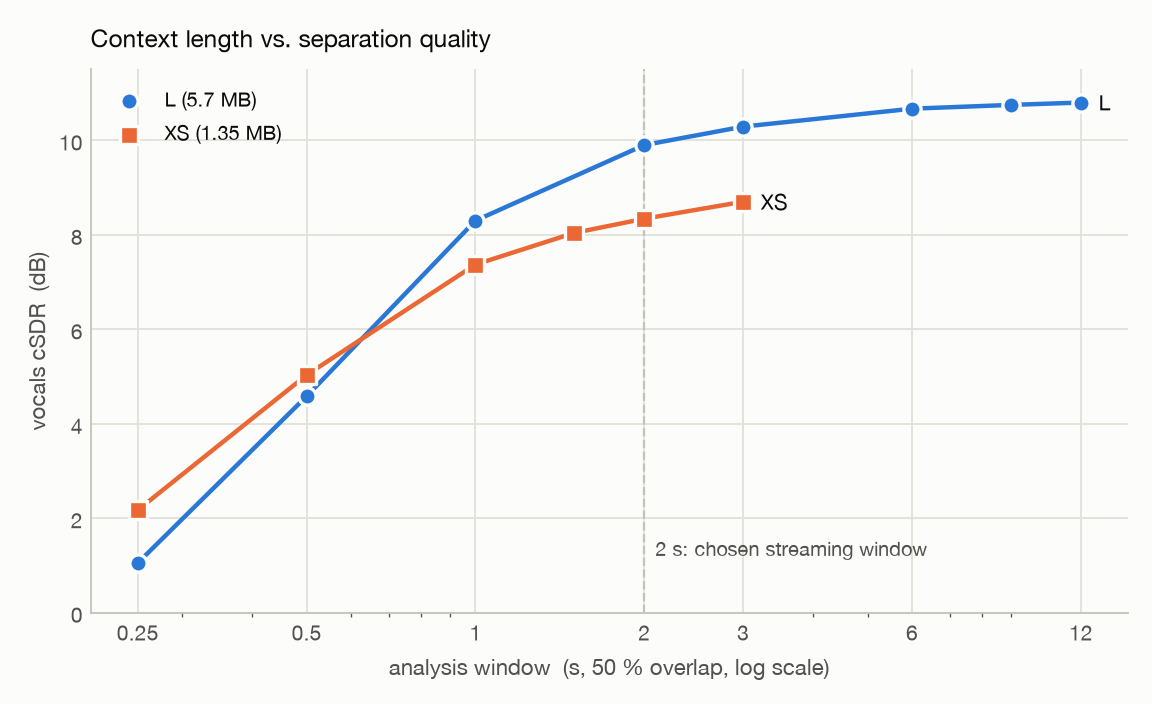
MUSDB18-HQ 測試集,全部 50 首。cSDR 的算法是把所有歌曲切成 1 秒片段、分別計算 SDR,再取中位數。 離線推論使用 12 秒視窗、75% 重疊。↑ 越高越好。
| 模型大小 | 參數量 | GMACs / 每 2 秒音訊 | INT8 檔案大小 | 人聲 cSDR(FP32) | 人聲 cSDR(INT8)↑ |
|---|---|---|---|---|---|
| L | ≈ 5.5 M | 38.8 | 5.72 MB | 10.95 | 10.93 |
| M | ≈ 4.2 M | 31.6 | 4.42 MB | 10.81 | 10.79 |
| S | ≈ 2.6 M | 16.2 | 2.75 MB | 9.95 | 9.94 |
| XS | ≈ 1.2 M | 7.16 | 1.35 MB | 9.13 | 9.13 |
| DTTNet(公開權重,以相同流程重新評分) | ≈ 5.0 M | – | 4.97 MB | 10.13 | 10.11 |
試聽片段
分數是相對於參考音軌的 cSDR,分別列出整首歌與播放器中 20 秒片段的分數。
人聲 20 秒片段 · 44.1 kHz 立體聲
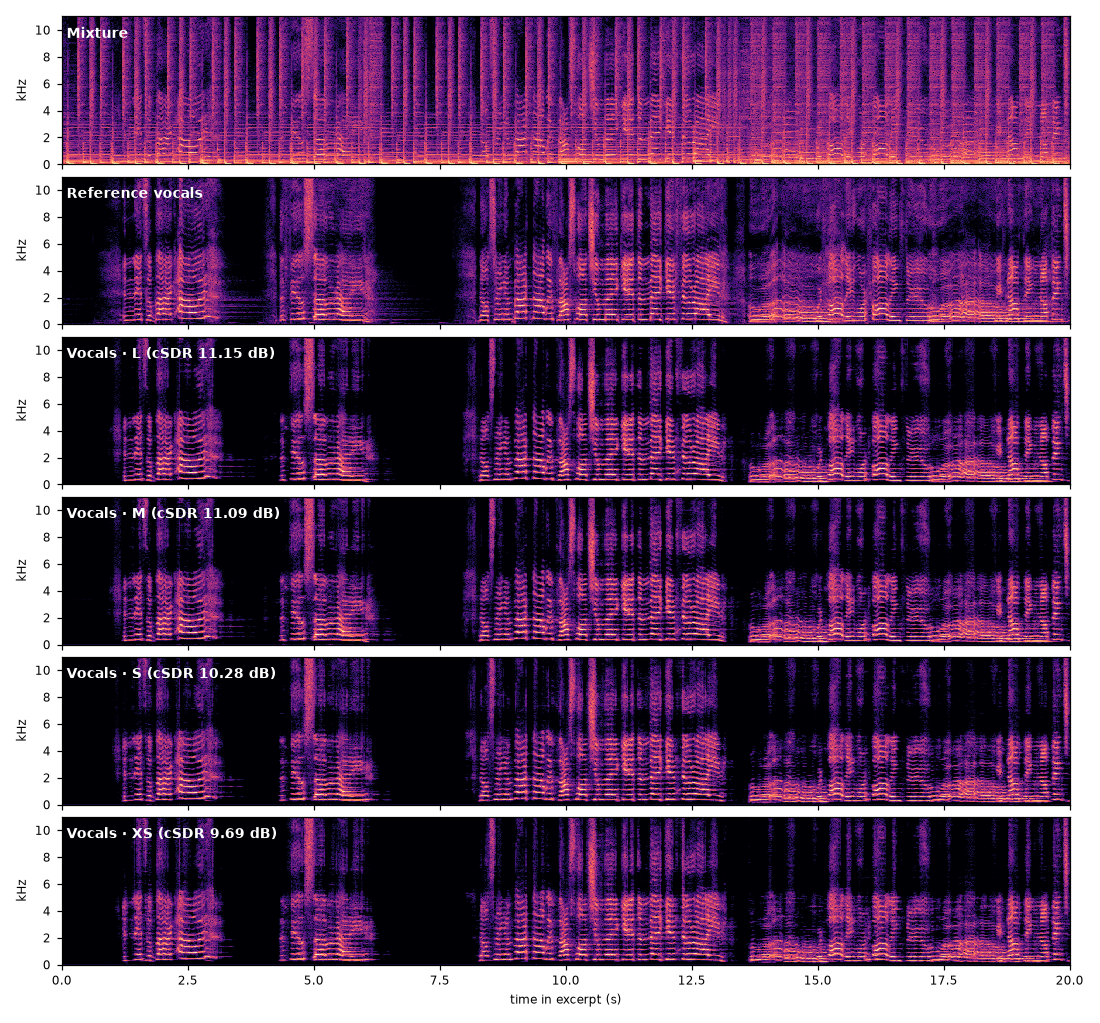
| 混音MUSDB18-HQ 測試集 | |
| LINT8 權重 · 約 5.5 M 參數 · 5.72 MBcSDR 整首 11.15 · 片段 11.23 dB | |
| MINT8 權重 · 約 4.2 M 參數 · 4.42 MBcSDR 整首 11.09 · 片段 11.30 dB | |
| SINT8 權重 · 約 2.6 M 參數 · 2.75 MBcSDR 整首 10.28 · 片段 10.39 dB | |
| XSINT8 權重 · 約 1.2 M 參數 · 1.35 MB · smallestcSDR 整首 9.69 · 片段 10.16 dB | |
| 參考人聲原始分軌 |
伴奏 20 秒片段 · 44.1 kHz 立體聲
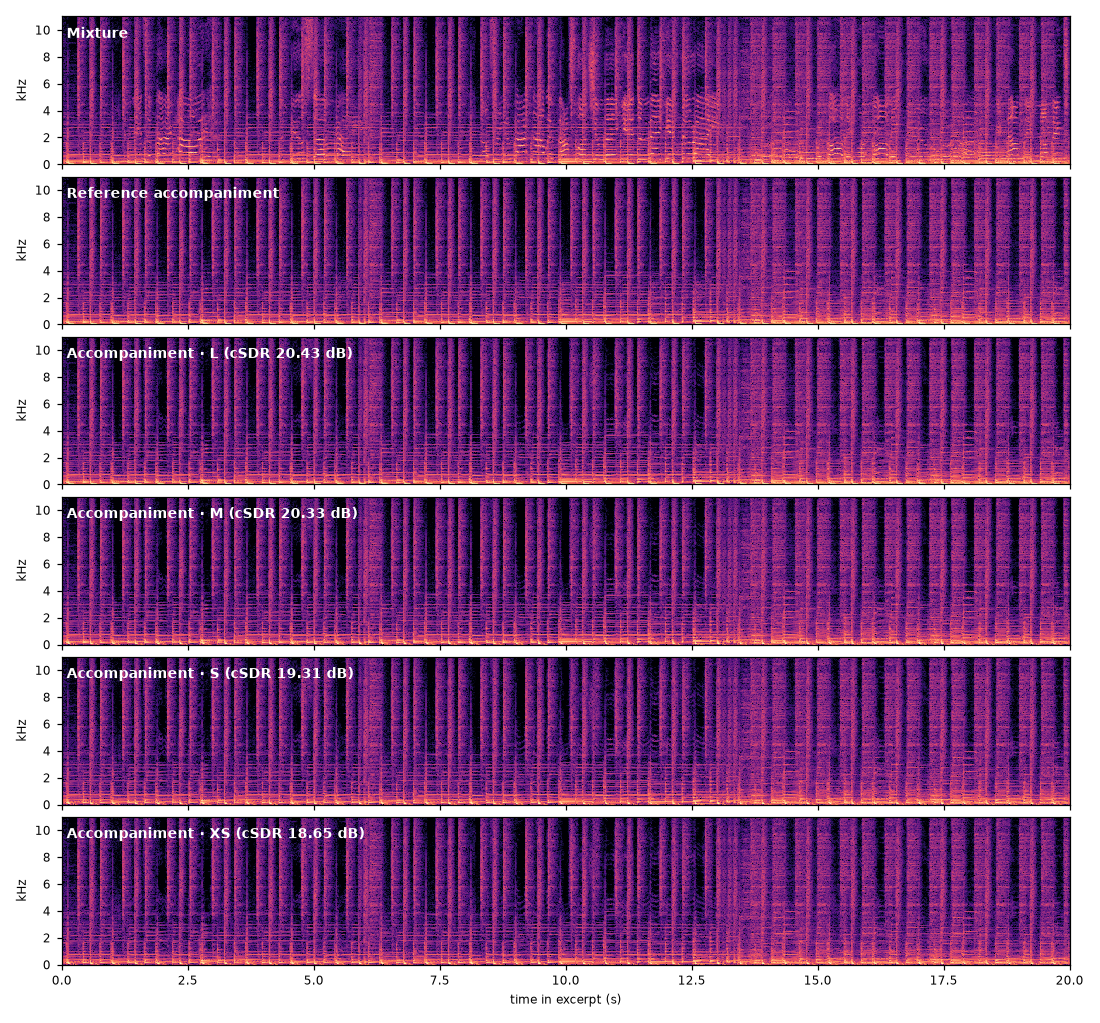
| 混音MUSDB18-HQ 測試集直接當作伴奏的 cSDR:整首 6.53 · 片段 9.31 dB | |
| LINT8 權重 · 約 5.5 M 參數 · 5.72 MBcSDR 整首 20.43 · 片段 20.95 dB | |
| MINT8 權重 · 約 4.2 M 參數 · 4.42 MBcSDR 整首 20.33 · 片段 20.88 dB | |
| SINT8 權重 · 約 2.6 M 參數 · 2.75 MBcSDR 整首 19.31 · 片段 19.90 dB | |
| XSINT8 權重 · 約 1.2 M 參數 · 1.35 MB · smallestcSDR 整首 18.65 · 片段 19.11 dB | |
| 參考伴奏原始分軌 |